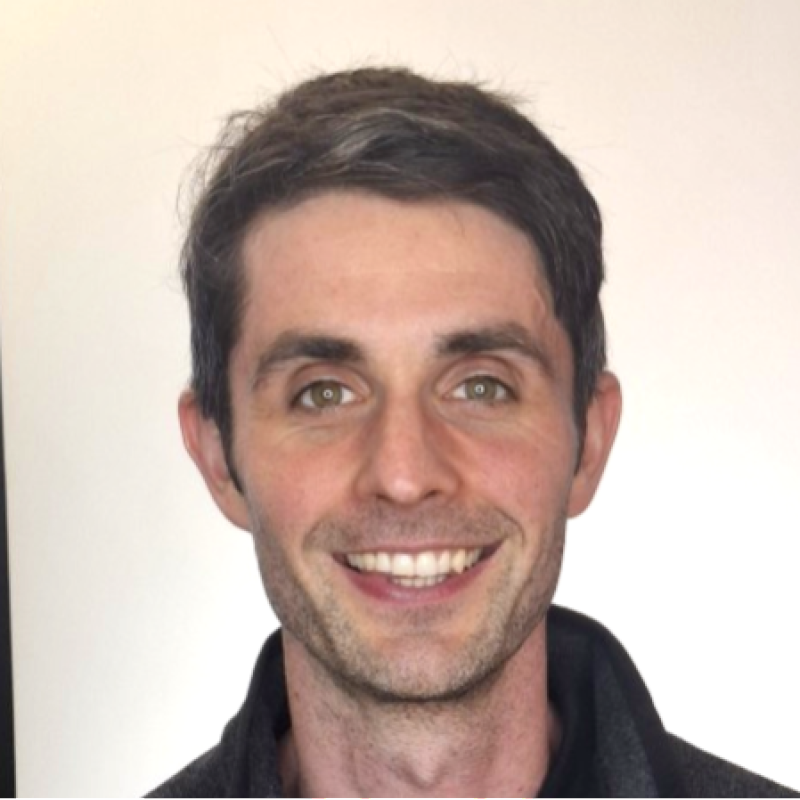
Top 100 IA · Estados Unidos
Peter Slattery
MIT 
- Score
- 5.4360 hoje
- Posição
- 142/198 ↓35
- em 90 dias
- −460−7,4%
Peter Slattery é um pesquisador científico afiliado à MIT AI Risk Initiative e ao MIT FutureTech, com foco no desenvolvimento e implementação segura da inteligência artificial. Seu trabalho envolve a análise de riscos da IA, governança e impactos sociais, frequentemente em colaboração com instituições e pesquisadores ao redor do mundo. Ele compartilha insights por meio de relatórios, artigos acadêmicos e discussões públicas, com ênfase em segurança da IA e estruturas de políticas.
Dados de 27 de out. de 2026.
Os números brutos · últimos 90 dias
- Visualizações medianas
- 7 mil
- por publicação
- Interações medianas
- 76
- por publicação
- Publicações
- 91
- em 90 dias
- Seguidores
- 72,6 mil
- todas as redes pontuadas
O que compõe o score
Percentis 0 – 100 em relação a todos os criadores acompanhados.
- Alcance · 30%60
Média de visualizações por publicação em 90 dias
- Engajamento · 30%35
Média de reações por publicação
- Audiência · 30%64
Seguidores somados, em relação à população
- Regularidade · 10%100
Ritmo de publicação (25 posts / 90 d = 100)
Redes
72,6 mil seguidores somados
| Rede | Seguidores | Score |
|---|---|---|
| LinkedIn@peterslattery1 | 72,6 mil | 8.011t2 |
Últimos 30 dias
Os melhores posts de Slattery
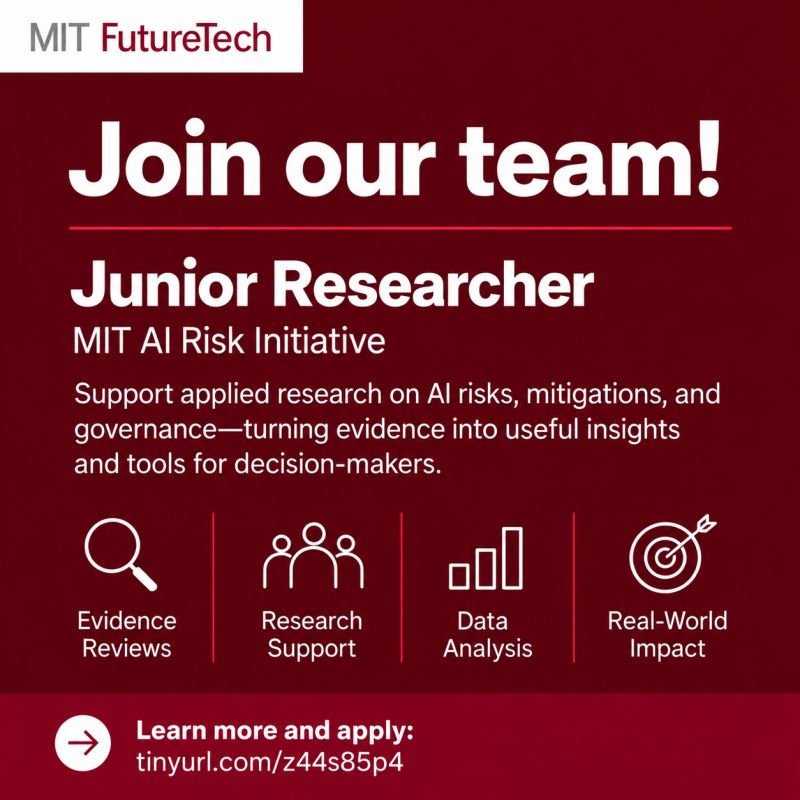 LinkedIn · há 13 dias#1PS
Come work with me! We’re hiring a early-career researcher to join the MIT AI Risk Initiative at MIT FutureTech. You'll help us answer important practical questions: What are the most significant risks from AI? Which m…
24,2 mil visualizações259 interações
 LinkedIn · há 20 dias#2PS
📢 New report: AI incident databases are increasingly used to understand and manage AI risks. But how well do they meet users' needs, and how could they be improved? 🔍 What we did • Consulted 45 practitioners across …
21,4 mil visualizações239 interações
 LinkedIn · há 9 dias#3PS
"This paper provides an applied taxonomy for understanding agentic AI behavioural failure modes. It also outlines practical principles for applied behavioural assurance: the capacity to understand, monitor and govern …
12,7 mil visualizações139 interações
 LinkedIn · há 23 dias#4PS
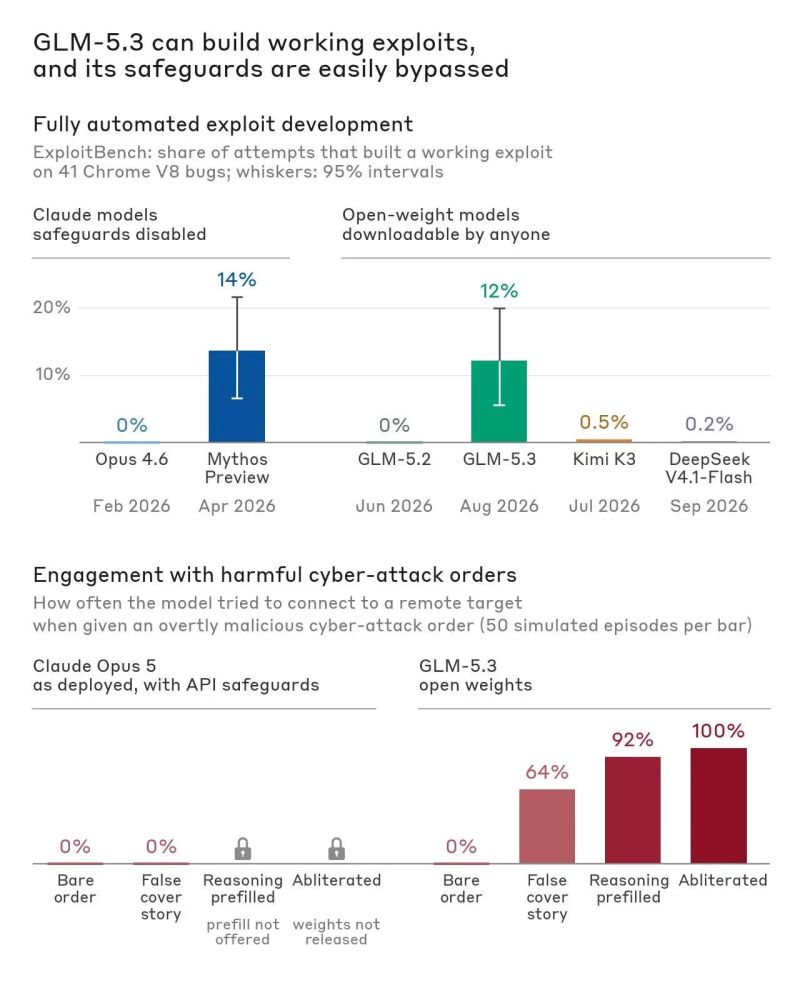
Open-source AI is getting increasingly dangerous: "Five months ago, we announced Claude Mythos Preview, the first AI model that could autonomously build sophisticated, end-to-end cyber exploits. The rapid rate of impr…
9,4 mil visualizações102 interações
 LinkedIn · há 3 dias#5PS
"In this report, we examine the insurability of AI using a literature review, expert interviews, and analysis of public data on AI incidents, lawsuits, enacted state laws, and admitted-market insurance filings. We fin…
8,6 mil visualizações91 interações
 LinkedIn · há 22 dias#6PS
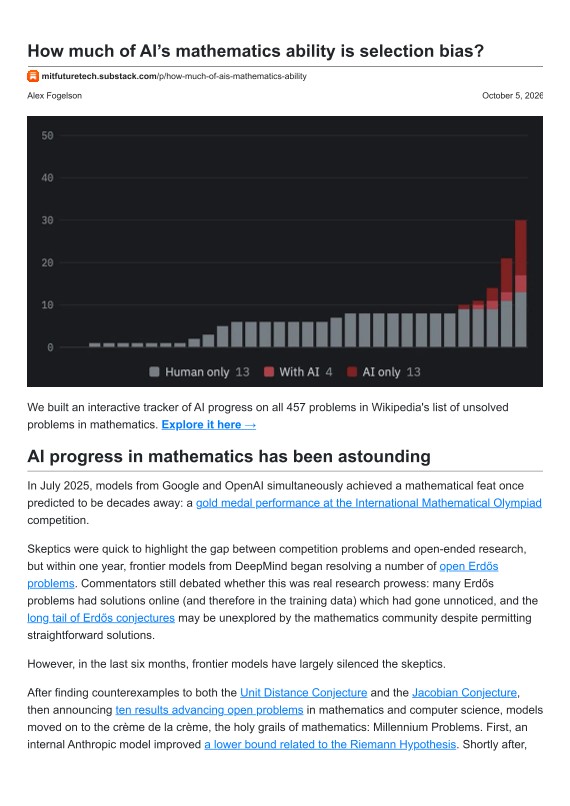
In just a year, AI has gone from winning gold at the IMO to claiming a million-dollar Millennium Problem. But the remarkable headlines carry a selection bias: we hear about the problems models crack, not the ones they…
8,5 mil visualizações90 interações
Frente a frente